 美国VPS_搬瓦工CN2 GIA VPS

- #!/usr/bin/env python
- # -*- coding:utf-8 -*-
- import hashlib
- import sqlite3
- dict_set = set()
- dict_md5 = {}
- def read_file(file):
- print(‘Reading file …’)
- with open(file, ‘r’, encoding=’utf-8′) as fr:
- for line in fr:
- dict_set.add(line.strip())
- msg = ‘There are {} lines in total…’.format(dict_set.__len__())
- print(msg)
- def md5():
- print(‘Calculating MD5…’)
- print(dict_set.__len__())
- for k in dict_set:
- pwd_md5 = hashlib.md5()
- pwd_md5.update(k.encode(‘utf-8’))
- v = pwd_md5.hexdigest()
- dict_md5[k] = v
- def insert2db():
- print(‘Write to database…’)
- conn = sqlite3.connect(‘md5.db’)
- cursor = conn.cursor()
- i = 1
- for k, v in dict_md5.items():
- print(k, ‘-‘, v)
- try:
- sql = "INSERT INTO MD5 (ID,PASSWD,PASSWD_MD5)\
- VALUES (‘{}’, ‘{}’, ‘{}’);".format(i, k, v)
- print(sql)
- cursor.execute(sql)
- i += 1
- except:
- pass
- cursor.close()
- conn.commit()
- conn.close()
- if __name__ == ‘__main__’:
- read_file(‘./dict/dict.txt’)
- # read_file(‘./dict/top10W.txt’)
- md5()
- insert2db()
- pass
复制代码
通过这个代码,应该可以正向计算得出MD5值,而且应该可以生成md5.db的数据库,现在问题是后台记录看到可以生成MD5,但无法写入db数据库,是为什么?
北京网友:我好像进错帖子,字母我都认识,在一起就不认识了
广东网友:1. 贴代码请用 gist
2. 你在 commit 之前就把 cursor 关了,估计是这个原因。一般 cursor 放着不管也没问题。
陕西网友:
是不是得先创建表?
- cursor.execute(”’CREATE TABLE MD5
- (ID INT PRIMARY KEY NOT NULL,
- PASSWD TEXT NOT NULL,
- PASSWD_MD5 TEXT NOT NULL);”’)
复制代码
commit 应该在 for 循环里面
dict_set = set()
dict_md5 = {}
dict_md5 的 keys 的数据结构就是一个 set(3.6 之后你可以当做有序的 set),字典的 key 值不能重复,因此可以缩减一些没必要的操作
SQLite 的主键声明为 INTEGER PRIMARY KEY 是自增的,因此不需要单独计算 ID 字段的值
河南网友:大佬可以将修改后的完整代码发下嘛,谢谢~
天津网友:直接删掉cursor就行了嘛?
内蒙古网友:dddddd
西藏网友:https://gist.github.com/JamCh01/3d2d5a00538efd89f2054b3d885abde9
陕西网友:谢谢大佬,我回去跑程序看看
澳门网友:删掉试了下,还是不行,无法生成
江西网友:删掉试了下,还是不行,无法生成
甘肃网友:另外大佬能不能再帮忙改善下代码,让python每次一行行读,一口气读整个txt文件6GB+的系统直接gg了,内存耗尽。。。
贵州网友:你没创建表吧?在34行后加一句
- cursor.execute(‘create table md5 (ID,PASSWD,PASSWD_MD5)’)
复制代码试一下?
山西网友:根据上个大佬的方法现在数据库成功生成了,然后发现一个小问题,python长时间读取大文件后系统内存不足,能不能让py分段读取同一个大文件?比如10GB的txt?
贵州网友:你试试看?重新写了份
https://gist.github.com/gougou6423/cf25822d4d0c1756b43b58f7d6076881
湖北网友:试了下,貌似不错,不过可以适当优化下嘛,比如每次读取几十或者几百行,提高下效率,现在速度略微偏慢了一点,等了蛮久
浙江网友:或者能不能修改什么参数设置读取量,现在读取写入速度有点慢了,每秒才1MB写入,1个200多GB的数据库得几天几夜才能生成。。。硬盘的写入设置在30MB/s可以嘛?不清楚这个速度下每秒读取多少行
上海网友:另外顺带问下,可以多线程CPU进行嘛,现在单线程CPU感觉利用不充分,有点浪费
安徽网友:写入后只有600多MB,貌似自行中断了,db数据库不完整,原先完整的应该是800多MB,600多MB的数据库查不到任何md5。。。
贵州网友:
https://gist.github.com/gougou6423/cf25822d4d0c1756b43b58f7d6076881
我这只有3-500k的数据进行测试,是正常的
你先弄少量数据试下呗
多线程稍微有点麻烦,同时写数据库可能会阻塞
你要把那个数据库文件先删了,重新建,因为主键设置了自增
青海网友:
https://gist.github.com/gougou6423/cf25822d4d0c1756b43b58f7d6076881
我这只有3-500k的数据进行测试,是正常的
你先弄少量数据试下呗
多线程稍微有点麻烦,同时写数据库可能会阻塞
你要把那个数据库文件先删了,重新建,因为主键设置了自增
陕西网友:另外确实,大一点的文件的话,大佬你这个代码生成不完整就中断了
江苏网友:
算md5的部分加上了多进程,效果不是很明显,sqlite只能单进程写,优化后写入大概20M左右,自测1G的字典需要6分钟的样子。改进后的代码
https://gist.github.com/gougou6423/cf25822d4d0c1756b43b58f7d6076881
这种数据量sqlite怕不是很合适,推荐换mysql吧
广东网友:好的,我回去试试,还能再多写入一些嘛?我那个字典估计至少有600g。。 。
辽宁网友:python 的多线程不是虚的么 实际上只有一个线程
湖南网友:大佬,有个问题,这个代码生成的数据库无法查询md5,感觉少了或者生成的内容有问题
福建网友:不认为多线程会有什么优化,那位朋友的代码在 hash 计算用了多进程,但是你的数据库是 sqlite,本就不要谈及性能
无论你开多少线程,只要访问同一张表都会锁住,实际都是顺序执行
至于大文件 IO 会造成内存问题,加个分段读即可
未经允许不得转载:美国VPS_搬瓦工CN2 GIA VPS » 大佬们帮看下这个py代码哪里有问题
 腾讯云轻量怎么购买,云轻量香港/美国/新加坡购买教程
 亏了,刚才退款了一个greencloud日本
 10欧的IPMI写什么申请理由好?
评论 0

Just my socks教程
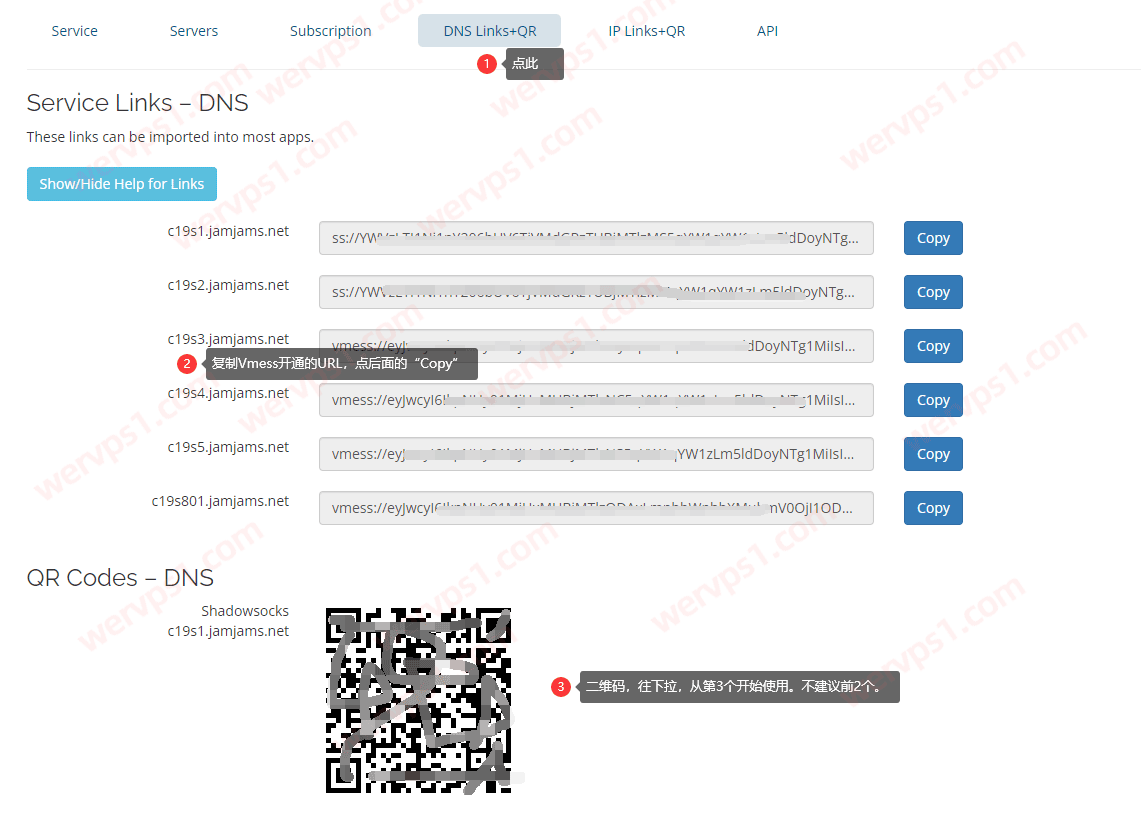
![]() 最新just my socks设置教程:DNS Links+QR(URL导入+二维码)添加阅读(3297)
 搬瓦工机场 Just My Socks 购买教程 Just My Socks优惠码/使用方法 Just My Socks Promo code 搬瓦工Shadowsocks购买 可支付宝阅读(51987)
![]() [更新]:just my socks支持TCP+TLS 可自助更换(小白必看)阅读(3782)
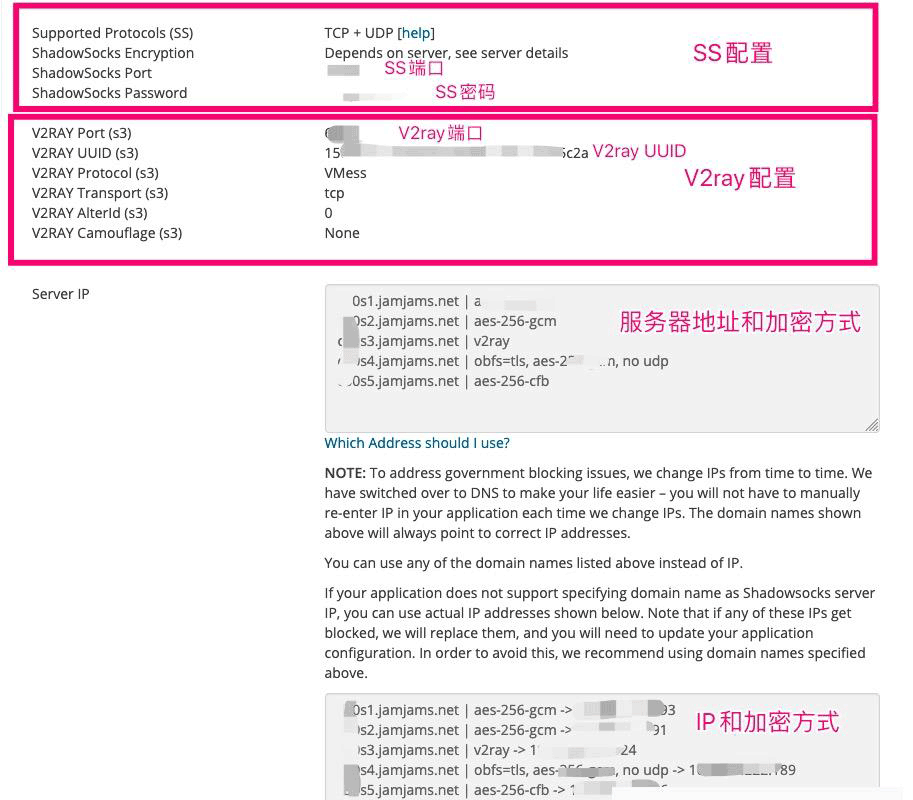
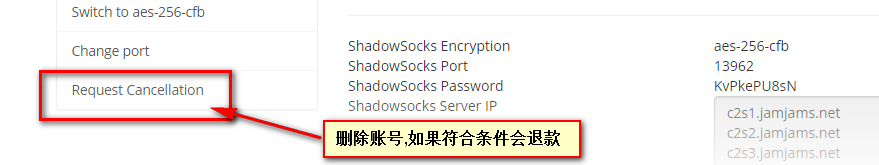
![]() 新手攻略:Just My Socks购买信息查看和设置教程阅读(4214)
![]() 搬瓦工JMS机场 JustMySocks新增V2ray方式,JMS v2ray设置教程阅读(6011)
![]() just my socks 搬瓦工机场优惠码 +just my socks常见问题阅读(2013)



觉得文章有用就打赏一下文章作者
支付宝扫一扫打赏

微信扫一扫打赏
